1. 想法的来源
8 月底逛知乎时看到了一篇帖子,主题是「有什么极简的个人博客推荐?」,这个 回答 推荐了 Astro 平台下的 AstroPaper 主题。
AstroPaper 简洁但不简陋,国外许多技术大佬的博客也都是类似的风格。当然了,也还有一些古典派,只用 HTML 来实现,这种已经不属于大佬行列,属于大神了。
我原先使用的是 Hexo + Butterfly,圆角卡片风格,文档和功能十分完善,中文互联网上的十个静态博客有九个半都是这个主题。我又想到了知乎上另一个问题 你见过的最棒的个人博客界面是什么样的? 下的 回答,总结得可谓是一针见血。🤣
我在使用 Butterfly 过程中遇到的最大问题是对图片的需求,每篇博文都需要一张封面,有时候很难找到符合博文主题的图片,就算自己绘制,找素材也很费时间。这时有人可能会说了,现在的 AI 这么强大,直接用 AI 画一张不就完事了吗?可以是可以,但我不想那么做。虽然我博客的第一读者是我自己,但偶尔也会有一些网友来到这里,我不希望他们一进来就看到 AI 制作的粗制内容(不过我的那些文章也不是什么「珍馐」),包括文章封面。
这时我内心已经萌发了要更改博客主题的想法,但还没有敲定使用 AstroPaper,看看 AI 有什么推荐吧:
- 保持 Hexo 平台不变,把主题换成 Cactus:风格和 AstroPaper 很类似,感觉也还不错
- 更换到 Hugo 平台,使用 PaperMod 或 Hugo Bear:风格也很简洁,同时 Hugo 相比于 Hexo 有更快的构建速度
这些主题都很简洁,但我大概率还是要进行二开:
- Hexo 的构建速度比较慢,同时页面会积累臃肿的 JS 资源
- Hugo 构建速度极快,适用于有大量文章的场景,但我全站的文章数量不到两百篇,不需要极致的构建速度。Hugo 也有 Hexo 一样的问题,会积累臃肿的 JS 资源,除此之外,它使用的 Go 模板语言比较反直觉,要修改底层布局比较麻烦
综合上述对比,我还是决定使用 Astro + AstroPaper 作为底座来迁移我的博客,二开相对容易,构建速度也不慢。
2. 三阶段迁移
2.1 迁移思路
我对前端的所有理解就是对 Node.js 的安装,好在现在 AI 的能力非常强,我只需要进行规划,实现全交给 AI 就行。
博客最重要的是内容,因此迁移的首要目标是保证内容的正常显示,比如永久链接、Mermaid 和 Katex 的渲染、代码块的高亮等。
在内容之外还有一些自定义页面和辅助功能,比如搜索、评论、访问统计等。
如果直接一次性迁移所有内容,不仅需要验证许多功能,而且当多个功能有关联时,某个出问题后也不好定位。
因此我决定将整个迁移过程分成三个阶段,首先保证内容和链接相比于原博客不发生改变,然后再按重要性、使用频率对剩下功能进行调整或优化。
2.2 第一阶段计划
第一阶段的重点是文章,而不是页面的外观:
- 保持文章链接不变
- Markdown 内容正常渲染,重点注意 Mermaid、Katex 和代码块的渲染
- 实现分类、标签页,且链接不变
更多细节优化清单
- 首页文章列表的日期显示
- 非中文显示
- 样式不统一,有时候有「更新于」
- 首页显示发表于,内容页显示发表于和更新于
- 引用块样式不够美观
- 太窄
- 最好圆角展示,直接参考 Butterfly
- Markdown 渲染器
- Emoji 表情使用
::书写时没有渲染:扫描博客内容,更换写法,不增加渲染逻辑 - 不支持
====高亮语法渲染 - Markdown 渲染验证可以看这篇文章的效果:一款简洁、高自定义化的 Markdown 编辑器——Typora
- Emoji 表情使用
- 中文字体使用 霞鹜文楷,代码字体使用 JetBrains Mono
- 代码块优化
- 显示语言名称
- 区分 Markdown 代码围栏渲染出的代码块和直接使用
<pre>标签的代码块
- 移除标题锚点,也就是标题后面的井号
2.3 第二阶段计划
这一阶段的重点是阅读体验,需要为网站添加必要的辅助功能来提高阅读体验:
- 建立 GitHub Actions 部署流程
- 实现 DocSearch 搜索,更新 DocSearch Crawler 爬取规则
- 实现系列文章
- 文章页添加目录,要求可折叠、显示阅读进度、支持响应式
- 分类支持子分类,并且要在文章页体现
- 接入 Twikoo 评论
- 接入开往
更多细节优化清单
- 建立一套低成本的自定义页面维护体系,日常内容只改 Markdown,而不是 Astro 代码
- 增加赞赏页
- 代码块显示优化
- 显示行号(参考 Butterfly)
- 浅色主题使用
One Light,深色主题使用One Dark Pro
- 完善网站信息
- 移动端下,文章页里的 Markdown 表格
- 撑宽整个页面
- 内容未按要求居中
- 阅读了 20% 多的内容后,才会出现「回到顶部」选项(AstroPaper 本身的问题,见 feat: improve back-to-top button behavior (#520))
2.4 第三阶段计划
经过前面两个阶段的迁移,新站已经具备上线条件。
我打算先让新站上线,一边使用一边收集可优化点,同时盘点原 Butterfly 旧站中哪些功能仍有价值,并考虑将它们迁移到新站上:
-
文章版权
-
增加友链页:
- 借鉴 Butterfly 的实现方式,
data.yaml中存放站点链接,link.md中存放站点信息后面的自定义信息 - 接入评论
- 借鉴 Butterfly 的实现方式,
-
文章页也添加赞赏信息
-
接入不蒜子
- 全站 URL 小写,旧链自动重定向到新链
- 文章阅读量不清零,将旧链的浏览量累加到新链上
- 优化待加载样式
- 优化全站浏览量样式
更多细节优化清单
-
Markdown 渲染优化
- Checkbox 样式
- 脚注样式
- 评论中的 Markdown 语法渲染失败
-
回到顶部优化
- 移动端图标缩小
- 统一全站的回到顶部逻辑与显示位置
- PC 的位置放在目录下
-
归档页优化
- 内容精简:移除每篇文章的描述信息
- 支持翻页
-
滚动感知的吸顶导航,参考 Butterfly
-
优化深色模式下的数学公式显示效果
-
移动端导航栏显示优化
- 样式优化
- 交互优化:点击其他区域后自动收起
-
增加失效图片的默认占位图片
3. 遇到的问题
前面上个阶段提到的问题与优化并不是全部,更多的优化和 BUG 修改穿插在日常使用过程中。
整个博客迁移过程还算顺利,但也遇到两个棘手的问题:
- DocSearch 认证
- 全站 URL 小写后的兼容
3.1 DocSearch 认证
迁移到新站后,页面布局和样式都发生了变化,原先的 DocSearch Crawler 自然也就不能再使用。
如果让我自己去更新这个爬虫,我肯定要耗费九牛二虎之力,而且还不一定对,但现在是 AI 时代,这对 AI 来说和开卷考试没什么区别。
既然如此,那我究竟遇到什么问题了呢?
更新完爬虫后,按照 AI 的提示,我尝试使用站点里的某个 URL 对爬虫进行测试。
这时页面上的错误阻塞了我的测试:
This domain is not DocSearch verified. Please verify your domain ownership or contact support for assistance.
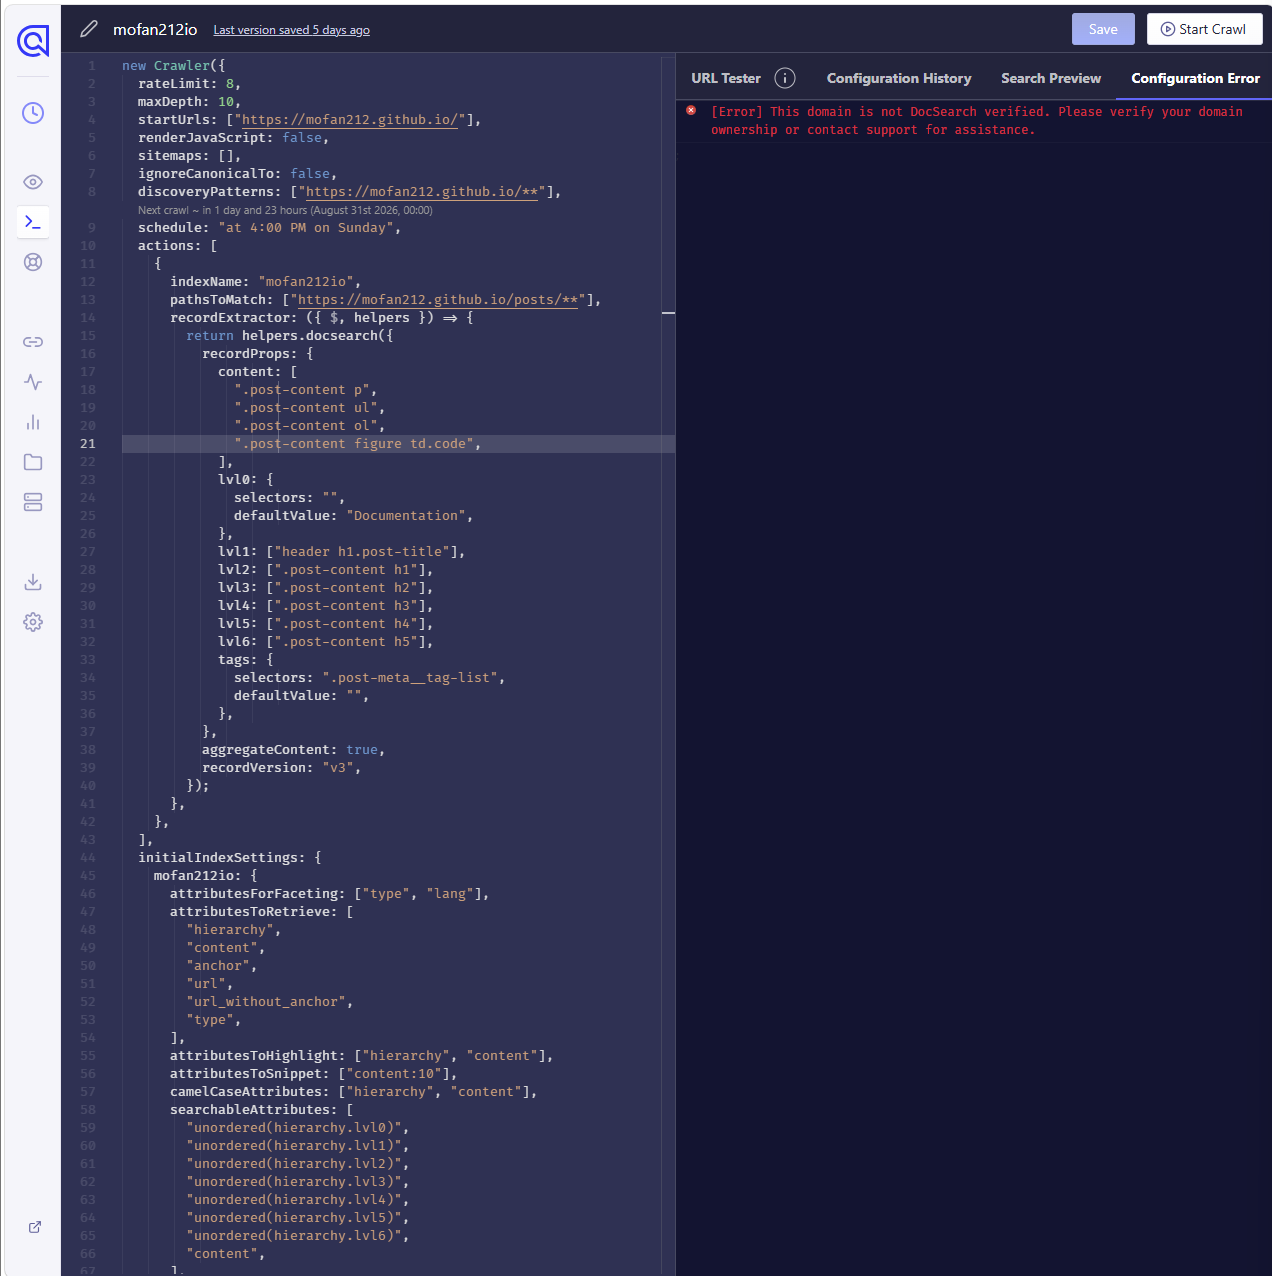
同时在 Domains 页面上也出现了类似的错误。
我将错误信息和截图告诉 AI 后,它告诉我先不要保存修改的爬虫代码,避免原来的索引失效。
它接着又说,点击 Domains 页面里的 Contact Support 并提交下面这段内容:
Hello Algolia Crawler Support,
I am the owner of the following existing DocSearch application and crawler:
Application ID: xxxxxxxxxx
Crawler name: mofan212io
Index name: mofan212io
Domain: https://mofan212.github.io
The Domains page shows that mofan212.github.io is verified and was added by the system.
However, the Crawler Editor and URL Tester display the following error:
"This domain is not DocSearch verified. Please verify your domain ownership or contact support for assistance."
The Domains page also displays:
"Domain Verification is disabled on application BAFEL7A6K1. Contact support to have one added manually."
Could you please manually mark mofan212.github.io as DocSearch verified for application BAFEL7A6K1?
The website has recently been migrated from Hexo to Astro, but the domain and existing article URLs remain unchanged. I need to update the crawler selectors and run a complete crawl for the new page structure.
I have attached screenshots of the Domains page and the Configuration Error.
Thank you,
Mofan简单来说就是向 Algolia 的支持团队提交工单,寻求他们的帮助。
如果不想使用系统的默认邮箱(比如 Windows 下的 Outlook)发邮件,那么需要将 support+crawler@algolia.com 设置为收件人,以下面的内容作为标题,邮件详情继续使用上述内容即可:
Domain Verification is disabled for DocSearch application BAFEL7A6K1我收到的第一次回复内容如下:
Hi Mofan,
Thank you for contacting the Algolia Support team!
By default, we have a limited view of your application. Since your question requires us to access your Crawler's configuration, would you mind granting us access to your application?
Please head over to the Algolia support access page to provide us with at least 14 days or more of read access. When you have completed this step, please confirm by replying to this email.
Thanks in advance, looking forward to your reply!
Best,
Lindsay Burton
Developer Support Engineer简单来说,Algolia 支持团队目前看不到我的爬虫配置,需要我临时授权他们读取我对应应用下的配置。
根据 AI 的指引,我向他们授予了 14 天的只读权限,并回复了以下内容:
Hi Lindsay,
I have granted Algolia Support read access to application xxxxxxxxxx for 14 days.
Please let me know if you need any additional information.
Thank you,
Mofan我原本以为这个问题会很快得到解决,但我在第二次回复中被告知一线支持团队无法直接修复这个问题,需要升级给工程团队进行调查。
又过了两天,我收到了第三次回复。在第三次回复中,工程团队认为旧爬虫抓取到了许多无效或打不开的 URL,让我继续排查。不过他们没有给出具体的 URL,因此在 AI 的帮助下,我询问他们能否提供一些示例,告诉我究竟是哪些 URL 出了问题。
不过在看到这第三次回复时我就感觉他们好像理解错了。
果不其然,他们确实理解错了。工程团队给我的示例 URL 可以正常打开,我想可能是因为上线了新站导致的?
我把我的疑惑发给 AI,AI 给我重新拟了一份邮件,在邮件里把事实讲清楚,并希望他们可以继续排查。
过了几个小时,我收到了一份新邮件。这次换人了,不再是先前的 Lindsay,而是 Lydia 在帮我处理。她告诉我已经确认了 This domain is not DocSearch verified 错误仍然存在,并且把问题交给了 Crawler 团队,让他们手动恢复域名的 DocSearch 验证状态。
这次处理相当迅速,不到十分钟我又收到了新邮件,Lydia 告诉我 Crawler 团队已经帮我手动恢复了验证。
之后,我继续借助 AI 的帮助完成了爬虫的更新和验证。
Algolia 支持团队使用 PDT(北美太平洋夏令时间,所属时区是 GMT-7),与北京时间(GMT+8)差了 15 个小时。我晚上睡前他们可能才刚上班,我们的交流最多也就在这一个小时里,平均下来,一天只能互相回一封邮件。再叠加前期问题被理解错误,所以从发送第一份寻求支持的邮件开始到正式解决问题,一共花了一周时间。
再换个角度,幸亏有 AI 的帮助,不然别说后面要与 Algolia 支持团队互通好几封邮件,我甚至可能都不会开始这次博客迁移。
感谢 AI,赞美 AI。
3.2 规范文章 URL
AI 的作用还远不止于此。
在旧站中,文章的 URL 并不规范,主要问题有:
- 大小写混用
- 存在特殊符号,比如
+、'和.,这些符号在复制、统计或者某些工具中容易产生编码歧义
借着这次迁移的机会,我打算规范下文章的 URL,统一使用小写 kebab-case,只允许出现小写字母、数字和短横线,并且还要:
- 保持兼容,即使用旧 URL 时,依然能够访问到规范后的 URL
- 不重新计算不蒜子的文章阅读量,需要在原来的数量上进行累加
保持兼容很简单。需要规范的文章保留两套标识 slug 和 legacySlug,其中 slug 是新的 URL,而 legacySlug 是原来的 URL。针对这些文章生成两套 HTML,在访问旧 URL 时,利用 JS 跳转到新 URL。
要实现阅读量的累加则要麻烦些,使用「旧 URL 计数桥接」:
访问新 URL
↓
新文章页加载一个隐藏 iframe
↓
iframe 地址为旧 URL
↓
不蒜子以旧 URL 作为 Referer 计数
↓
iframe 将旧 page_pv 返回新文章页显示这样无论用户访问旧 URL 还是新 URL,最终都只会给旧 URL 对应的不蒜子记录增加一次访问量。新 URL 不建立另一套文章计数,不再额外加载一次不蒜子。
具体来说:
-
迁移前已经存在的、需要规范 URL 的文章:同时有
slug和legacySlug,访问新 URL 时隐藏加载旧 URL,以延续原阅读量 -
迁移后新增的文章:只有规范的
slug,直接按新 URL 请求不蒜子,不使用 iframe
上面的方案都是由 GPT 6 提出,后续实现也交给它完成,最后的效果也意外地不错,完全满足我的要求。
这就是 AI。
AI 时代下想法比实现更加重要。
4. 参考过的站点设计
AstroPaper
- https://tangbinqiang.github.io/ :工具集 页面的卡片样式
- https://amanhimself.dev/ :Projects 页面的卡片样式
Cactus
- https://reinhart-l.cn/ :全站浏览量样式参考
附录 1. 优化 Codex 的规则
GPT 5.6 贼喜欢补全,有时候改一点需求要改好多内容,也不能说它改的不对,就是不够精简。突然灵光一现,想到了这个,用了几天,效果意外地还不错:
- 每完成一轮实质性修改后,以及任务准备完成前,反问一句「真的需要改这么多吗?」如果答案是不需要,精简后再次反问,直到答案是需要这句规则在写 SKILL、维护 SKILL、写后端逻辑代码时很有帮助,但是在以下的场景会有问题:
- 优化前端显示效果时,这句话会用最小实现完成,但最终效果可能就没那么美观了,甚至出现 AI 先改得很美观,但是触发这句话后,AI 又会进行精简,最后变得不美观,还要进行二次修复
在 Skill 和后端逻辑中,必要性通常能根据职责、正确性和测试判断。但在前端视觉任务中,间距、层次、阴影、动效等细节单独看都像「可以删」,组合起来却决定最终质感。反复追问「真的需要改这么多吗?」会让 AI 默认产生删减压力,把已经达到的视觉效果当成冗余。
「真的需要改这么多吗?」是一个带有删减倾向的诱导式问题,它把优化对象设成了改动量,更合理的是审查每项改动的实际贡献:
- 每完成一轮实质性修改后,以及任务准备完成前,内部自问「真的需要改这么多吗?」若存在不影响任务完成度和成果质量的内容,精简后再次自问;一旦继续精简会造成退化,就停止精简